
Промты для Qwen: примеры запросов и рекомендации по их составлению
Нередко пользователи пишут промт для Qwen наугад, и результат выходит непредсказуемым: один раз модель выдает то, что нужно, а в следующий — уже уходит в совершенно другую сторону. Причина проста: Qwen, как и другие большие языковые модели, чувствителен к формулировкам, структуре запроса и контексту. Без понимания базовых принципов промптинга можно потратить время на переделки, но так и не получить того, что требуется.
В этой статье я разберу, как правильно составлять промты для Qwen: от простых текстовых задач до работы с кодом и изображениями. Покажу готовые шаблоны, объясню логику их построения и подскажу, где найти сервисы с доступом к разным версиям Qwen. Материал подойдет и новичкам, и тем, кто уже работал с нейросетями, но хочет выжать из Qwen больше.
Топ-10 лучших сервисов с доступом к Qwen в 2026 году
- Study AI — сервис позиционирует Qwen как рабочую модель «на каждый день», которая не тратит лимиты более дорогих нейросетей: бесплатный чат с Qwen 3 от Alibaba для повседневных текстовых задач (черновики, заголовки, объяснения и простые скрипты).
- MashaGPT — агрегатор 50+ нейросетей в одном интерфейсе, где Qwen3 Pro работает как генератор и редактор изображений.
- GPTunneL — ИИ-суперапп на 200+ моделей с оплатой за токены без обязательной подписки; в каталоге есть Qwen 3.8 Max, флагманская модель Alibaba.
- RANVIK — универсальная русскоязычная платформа, объединяющая генерацию текста, изображений, видео, озвучки и музыки в одном интерфейсе.
- SmartBuddy — площадка, открывающая доступ к Qwen3 Coder Plus, модели для программирования с контекстом до 1 млн токенов и архитектурой MoE на 480 млрд параметров.
- Syntx AI — платформа на 100+ ИИ-инструментов, где Qwen доступен для работы с текстом и кодом.
- chad — адаптированный доступ к ИИ-моделям (Qwen, ChatGPT, Claude, Gemini, Midjourney и другим) с оплатой внутренними «искрами».
- ruGPT — русскоязычный сервис для работы с текстом, изображениями, видео и голосом прямо в браузере без регистрации.
- STIVA.ai — доступ к флагманской Qwen 3.8 Max с контекстом 1 млн токенов и мультимодальным вводом: текст, изображения, видео.
- ggsel — маркетплейс цифровых товаров, где продаются API-доступы с моделями Qwen.
Что такое Qwen и как с ним работать через промты
Qwen — семейство больших языковых моделей от Alibaba Cloud, которое охватывает текстовые задачи, программирование, анализ данных и генерацию изображений. В линейке есть версии с разным размером контекста (от 8 тыс. до 1 млн токенов), мультимодальные варианты для работы с картинками и специализированные сборки вроде Qwen Coder для разработчиков. Все версии доступны через API, веб-чат и локальный запуск — выбор зависит от задачи и требований к приватности.
Возможности модели: от текста, через анализ данных и до генерации изображений
Текстовые версии Qwen справляются с написанием статей, переводом, рерайтом и структурированием информации на русском языке. Модель понимает профессиональную терминологию, сохраняет стиль исходника при редактуре и может извлекать факты из больших документов. Qwen Coder заточена под код: генерирует функции, объясняет чужие решения, находит ошибки и предлагает рефакторинг на Python, jаvascript, C++, SQL и других языках.
Мультимодальные версии (Qwen-VL) анализируют содержимое картинок — описывают сцену, читают текст с фото, отвечают на вопросы по схемам и графикам. Qwen Image генерирует новые изображения по описанию: от фотореалистичных кадров до иллюстраций и рекламных баннеров. В отличие от текстовых моделей, где можно получить результат за один запрос, с картинками часто приходится итерировать: уточнять композицию, свет, детали.
Почему промт определяет качество ответа
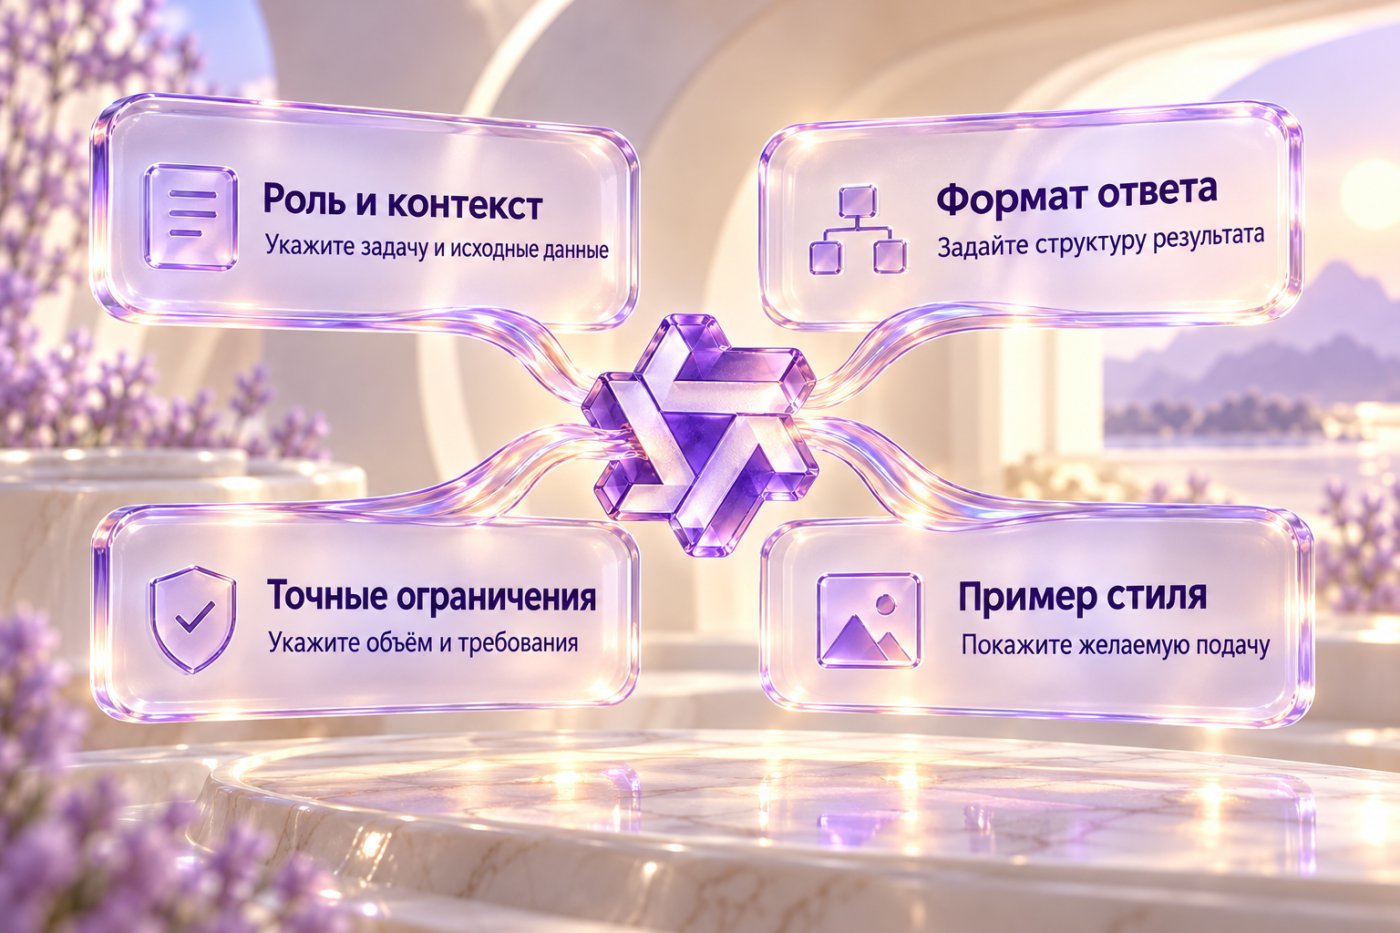
Модель не угадывает намерения — она интерпретирует запрос буквально. Если в промте не указан формат ответа, Qwen выберет произвольный: может вернуть развернутое эссе вместо тезисов или одно предложение вместо пошаговой инструкции. Размытая задача типа «расскажи про маркетинг» даст общий пересказ из учебника, а конкретная формулировка с контекстом и ограничениями — рабочий черновик под вашу ситуацию.
Этот ИИ чувствителен к деталям: если в промпте для Qwen указать «отвечай кратко», но не задать лимит слов, модель все равно может выдать три абзаца. Если попросить «писать без канцелярита», но не показать пример желаемого стиля, она уберет штампы, но заменит их нейтральными конструкциями. Чем точнее сформулированы роль, контекст, формат и ограничения, тем меньше правок понадобится после первого ответа.
Принципы составления рабочего промта для Квен
Четыре элемента эффективного запроса: роль, задача, контекст и формат
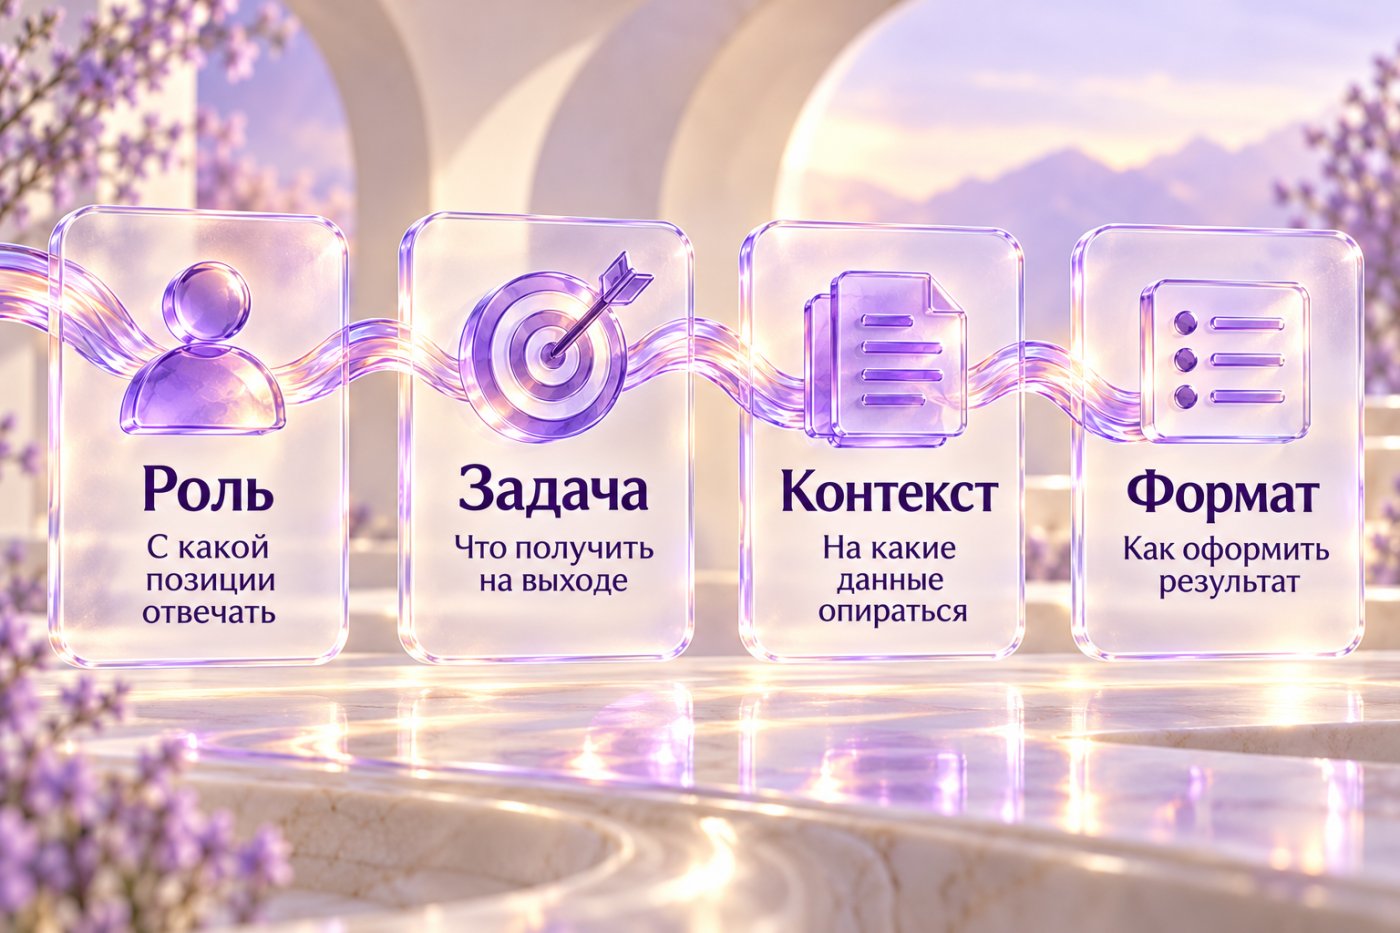
Роль задает угол зрения, с которого модель будет решать задачу. Вместо абстрактного «ты — эксперт» лучше конкретизировать: «ты — технический писатель, который объясняет сложные концепции разработчикам среднего уровня» или «ты — маркетолог, составляющий короткие посты для ВКонтакте». Роль влияет на выбор терминов, структуру ответа и уровень детализации.
Задача — это то, что нужно получить на выходе: текст статьи, план презентации, рефакторинг функции, список идей. Чем конкретнее формулировка, тем точнее результат. Вместо «напиши о нейросетях» лучше: «напиши вводный абзац на 150 слов, объясняющий, чем языковая модель отличается от чат-бота, для читателей без технического бэкграунда».
Контекст дает модели исходные данные: целевая аудитория, ограничения, источники, на которые можно опираться. Если нужно переработать чужой текст, приложите фрагмент. Если генерируете код, укажите язык, фреймворк, версию библиотеки и требования к производительности. Контекст сокращает количество догадок со стороны Qwen и снижает риск, что она выдумает детали.
Формат определяет структуру ответа: таблица, маркированный список, JSON, чистый текст без заголовков, пошаговая инструкция. Если формат не задан, модель выберет сама — и с великой долей вероятности он окажется неудобным для вас. Указывайте объем (150 слов, три идеи, пять строк кода), тон (деловой, дружеский, нейтральный) и ограничения (без вводных конструкций, без повторов, без технического жаргона).
Язык и формулировки: на что реагирует модель
Qwen понимает русский язык и смешанные запросы, где часть терминов на английском. Если в промте для нейросети Qwen встречаются профессиональные термины (API, рефакторинг, лид-магнит), модель сохранит их в ответе и не будет переводить на бытовой язык. Это полезно для технической документации и маркетинговых текстов, где замена терминов снижает точность.
Конкретные глаголы работают лучше абстрактных. Вместо «опиши» используйте «перечисли пять причин», «объясни разницу между X и Y», «покажи, как реализовать функцию». Вместо «сделай лучше» — «убери повторы, сократи до 100 слов, замени пассивные конструкции активными». Чем меньше интерпретаций у формулировки, тем предсказуемее результат.
Модель реагирует на примеры сильнее, чем на описания. Если нужен определенный стиль или формат, покажите образец: «Ответь в таком же духе: [пример]. Сохрани структуру и тон». Qwen скопирует длину предложений, выбор слов, расстановку акцентов. Этот прием работает для постов, писем, описаний товаров — везде, где важна однородность подачи.
Чего избегать: расплывчатость, противоречия и лишние детали
Размытые формулировки вроде «расскажи подробно» или «дай полную информацию» не задают границ — модель может выдать и три абзаца, и три страницы. Лучше указать объем явно: «200–250 слов», «пять пунктов списком», «три абзаца по четыре предложения». Так проще контролировать итоговый размер и не тратить время на сокращение.
Противоречия в промте сбивают Qwen с толку. Если попросить одновременно «писать кратко» и «раскрыть тему полностью», модель выберет что-то среднее — и часто не то, что нужно. Если требуется и краткость, и полнота, разбейте задачу на два запроса: сначала развернутый ответ, потом сжатие до тезисов. Цепочка промтов работает надежнее одного перегруженного.
Лишние детали — это биография несуществующего пользователя, история проекта, философские размышления о роли ИИ. Qwen обрабатывает весь текст промта, но чем больше вводных, тем выше шанс, что модель зацепится за второстепенное. Оставляйте только то, что влияет на результат: исходные данные, требования, ограничения.
Готовые промты для типовых задач
Работа с текстом: статьи, письма, резюме, перевод и рерайт
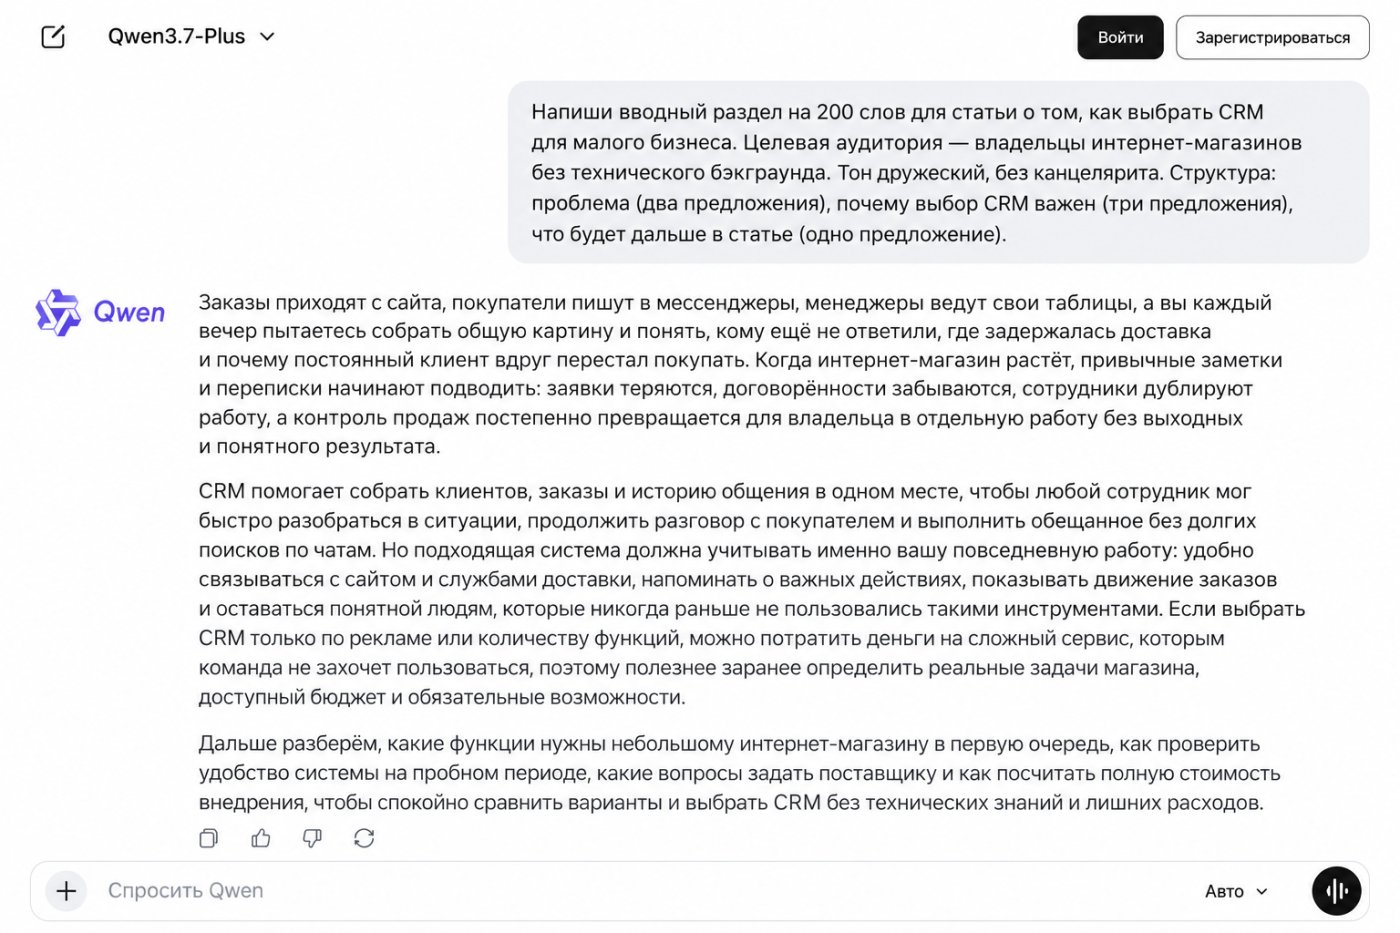
Готовый промт для статьи:
«Напиши вводный раздел на 200 слов для статьи о том, как выбрать CRM для малого бизнеса. Целевая аудитория — владельцы интернет-магазинов без технического бэкграунда. Тон дружеский, без канцелярита. Структура: проблема (два предложения), почему выбор CRM важен (три предложения), что будет дальше в статье (одно предложение)».
Для делового письма:
«Составь письмо партнеру с предложением совместного вебинара. Тон деловой, но не формальный. Объем — 100–120 слов. Структура: приветствие, суть предложения (тема вебинара, даты, выгоды для обеих сторон), призыв к действию. Не использовать штампы вроде "надеемся на плодотворное сотрудничество"».
Рерайт:
«Перепиши этот абзац так, чтобы он звучал менее академично и был понятен читателям без специального образования. Сохрани все факты и цифры. Замени сложные термины простыми объяснениями. Объем — не более 150 слов. [Вставьте исходный текст]».
Перевод с сохранением стиля:
«Переведи этот текст на английский. Сохрани неформальный тон, идиомы замени на близкие по смыслу английские выражения. Технические термины (API, endpoint, payload) оставь без изменений. [Вставьте исходный текст]».
Анализ и обработка информации: пересказ, извлечение данных, структурирование
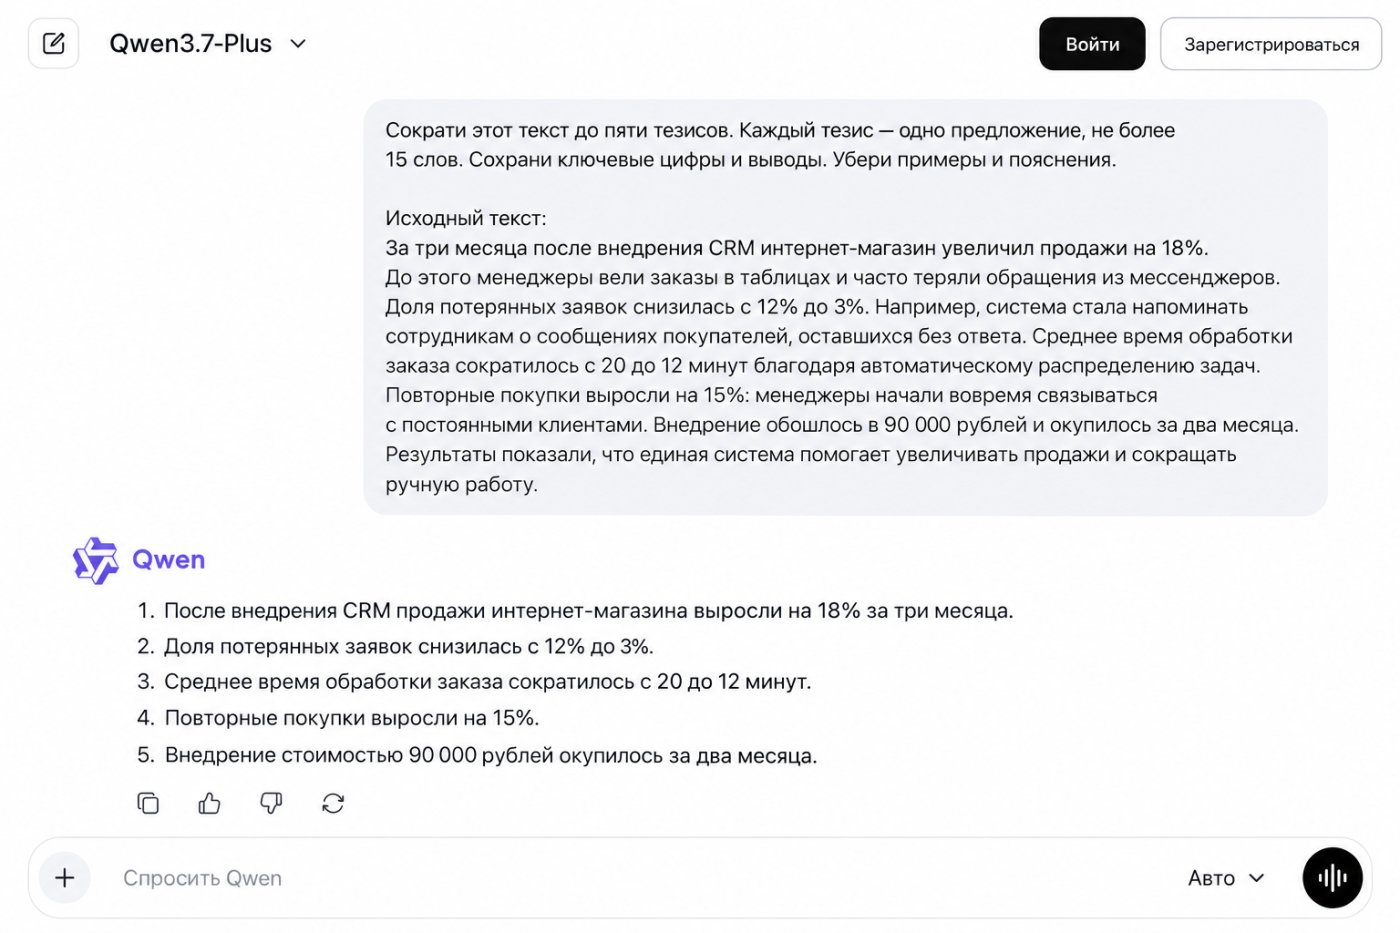
Краткий пересказ:
«Сократи этот текст до пяти тезисов. Каждый тезис — одно предложение, не более 15 слов. Сохрани ключевые цифры и выводы. Убери примеры и пояснения. [Вставьте исходный текст]».
Извлечение данных:
«Прочитай этот документ и выпиши в таблицу: название компании, контактное лицо, телефон, email, дату следующей встречи. Если какое-то поле отсутствует, использовать "—". [Вставьте текст документа]».
Структурирование хаотичных заметок:
«Преобразуй эти заметки в логичный план презентации. Раздели на три–пять разделов с подпунктами. Убери повторы и второстепенные детали. Каждый раздел начинай с краткого заголовка (два–четыре слова). [Вставьте заметки]».
Ответы по документу:
«Прочитай этот договор и ответь на вопросы: 1) Какой срок действия? 2) Условия расторжения? 3) Штрафы за просрочку? Ответы давай цитатами из документа с указанием пункта. [Вставьте текст договора]».
Код и техническая документация: написание, отладка и пояснения
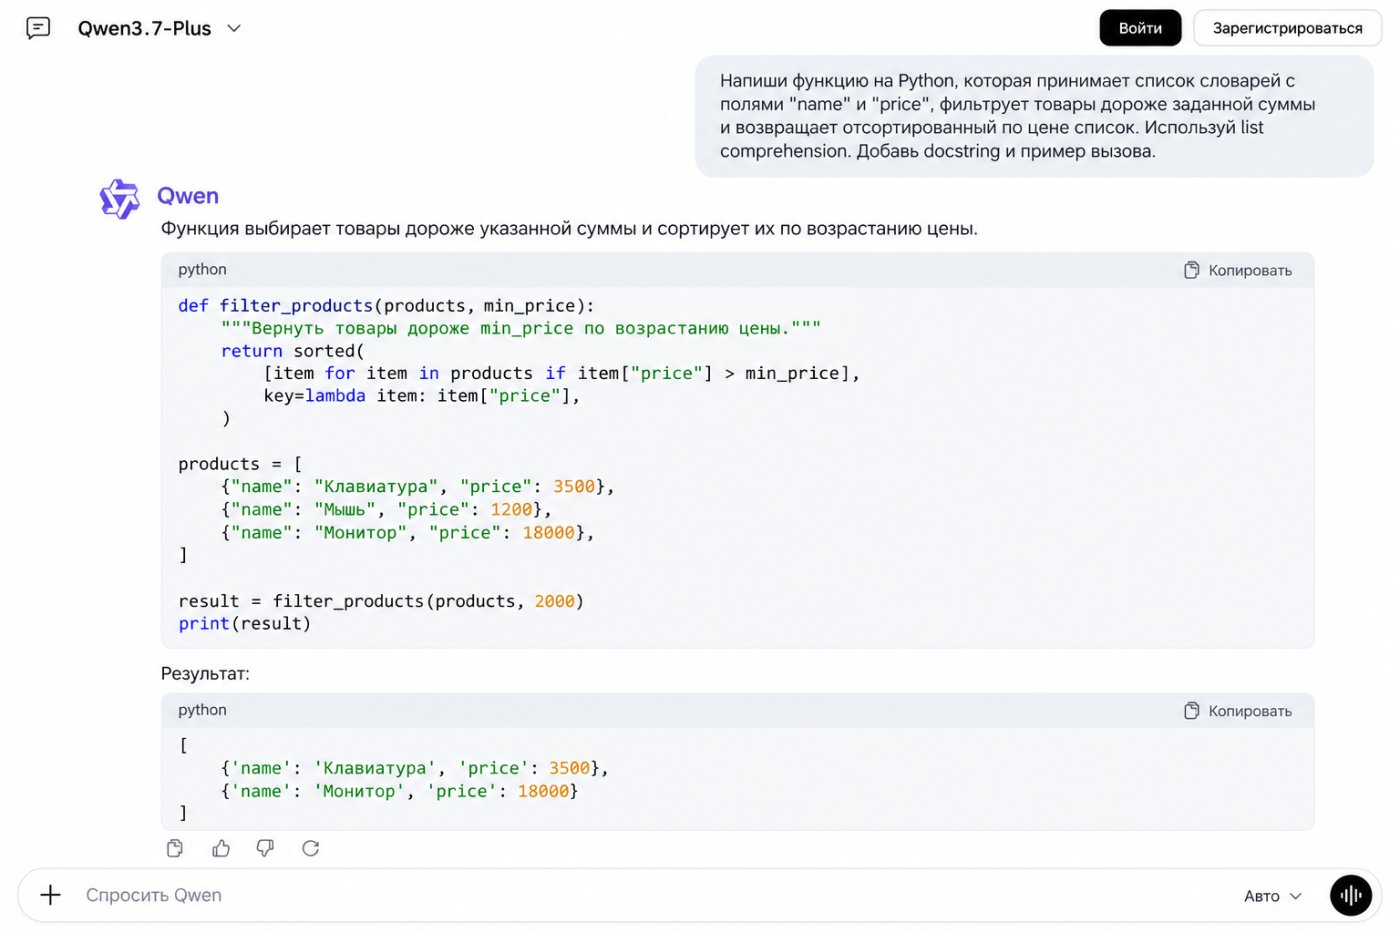
Генерация функции:
«Напиши функцию на Python, которая принимает список словарей с полями "name" и "price", фильтрует товары дороже заданной суммы и возвращает отсортированный по цене список. Используй list comprehension. Добавь docstring и пример вызова».
Отладка:
«Вот функция на jаvascript и ошибка, которую она выдает: [вставьте код и текст ошибки]. Объясни, в чем причина ошибки, и предложи исправленный вариант. Поясни, почему твое решение работает».
Рефакторинг:
«Перепиши эту функцию так, чтобы она стала читаемее: разбей на подфункции, замени магические числа именованными константами, добавь комментарии. Логика должна остаться неизменной. [Вставьте код]».
Документация:
«Напиши README для этого проекта на GitHub. Включи: описание проекта (два предложения), требования (версии библиотек), инструкцию по установке (три шага), пример использования (фрагмент кода с комментариями). Тон — для разработчиков среднего уровня. [Вставьте описание проекта]».
Креативные задачи: идеи, сценарии, названия и концепции, картинки
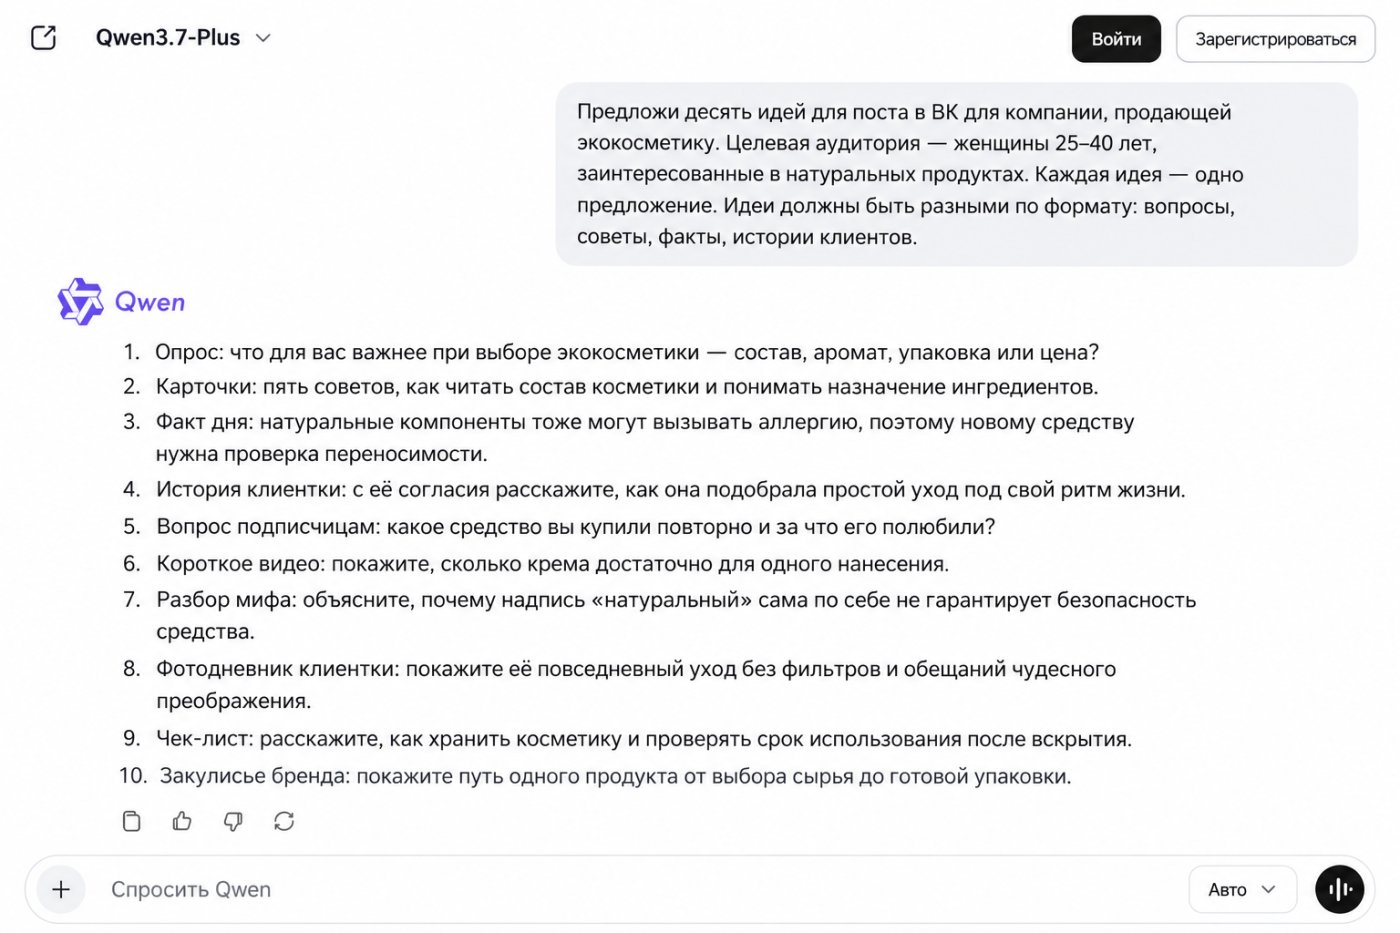
Генерация идей:
«Предложи десять идей для поста в ВК для компании, продающей экокосметику. Целевая аудитория — женщины 25–40 лет, заинтересованные в натуральных продуктах. Каждая идея — одно предложение. Идеи должны быть разными по формату: вопросы, советы, факты, истории клиентов».
Сценарий видео:
«Напиши сценарий 30-секундного видео для TikTok, объясняющего, что такое API. Целевая аудитория — начинающие разработчики. Структура: хук (первые три секунды), объяснение через простую метафору, призыв подписаться. Укажи тайминг для каждого блока».
Нейминг:
«Предложи пять названий для мобильного приложения, которое помогает планировать еженедельное меню и автоматически составляет список покупок. Названия должны быть короткими (одно–два слова), легко запоминающимися и доступными как домены .com».
Промт для изображения в Qwen Image:
«Сгенерируй реалистичное фото: рабочий стол дизайнера, вид сверху, на столе ноутбук, планшет, кофейная чашка, блокнот с эскизами. Освещение естественное, дневное. Композиция симметричная, формат 16:9. Цветовая гамма теплая, бежево-коричневая. Без текста на предметах».
Как улучшить ответ, если результат не устроил
Уточнение через диалог: дожимаем нужный результат
Если первый ответ Qwen близок к нужному, но требует правок, не переписывайте промт с нуля — уточните в следующем сообщении. Например: «Сократи до 100 слов, убери второй абзац, замени термин "конверсия" на "процент покупок"». Модель сохраняет контекст диалога и применит изменения к уже сгенерированному тексту.
Уточняющие вопросы работают, когда модель предложила несколько вариантов, но непонятно, какой выбрать. Попросите: «Объясни, чем первый вариант отличается от третьего по тону и структуре. Какой из них лучше для email-рассылки, а какой — для поста в блоге?» Qwen разберет плюсы и минусы, и решение станет очевиднее.
Если ответ ушел не в ту сторону, не пытайтесь исправить его итерациями: проще начать заново. Напишите: «Забудь предыдущий вариант. Вот новая задача: [переформулированный запрос]». Иногда модель «застревает» на неудачной интерпретации, и свежий промт дает лучший результат, чем пять правок.
Управление стилем, тоном и объемом
Для делового стиля указывайте: «Тон формальный, без разговорных выражений и восклицательных знаков. Предложения длинные, структурированные. Используй пассивные конструкции там, где это уместно».
Для дружеского: «Тон неформальный, как в разговоре с коллегой. Короткие предложения, можно вопросы и эмодзи. Избегай канцелярита».
Объем контролируется жесткими рамками: «Не более 150 слов» работает надежнее, чем «кратко». Если модель систематически превышает лимит, добавьте в промт: «Уложись строго в 150 слов. Если не получается, сокращай детали, но сохрани главные мысли». Qwen начнет приоритизировать сжатость.
Если нужен текст с определенным ритмом (например, для лендинга), задайте структуру явно: «Первый абзац — два предложения. Второй — три предложения. Третий — одно предложение. Каждое предложение начинается с глагола». Формальные ограничения заставляют модель подбирать формулировки аккуратнее.
Метод примеров и пошаговое решение
Метод примеров (few-shot prompting): покажите модели два–три образца желаемого формата, затем попросите создать новый по тому же шаблону. Например: «Вот три заголовка для статей: [примеры]. Придумай еще пять в том же стиле: короткие, с цифрой в начале, без вопросов». Qwen скопирует и воспроизведет структуру и тон.
Пошаговое решение полезно для сложных задач: математических расчетов, логических выводов, отладки кода. Добавьте в промпт: «Реши задачу пошагово. Объясни каждый шаг. В конце проверь ответ и укажи, правильный ли он». Это снижает риск ошибок, особенно в расчетах и многоступенчатых рассуждениях.
Если модель должна следовать строгому алгоритму, опишите его списком: «1. Прочитай исходный текст. 2. Выдели ключевые термины. 3. Для каждого термина напиши одно предложение с пояснением. 4. Объедини пояснения в абзац». Qwen будет двигаться по шагам последовательно и не пропустит этап.
Продвинутые приемы для сложных сценариев
Цепочки промптов: разбиваем большую задачу на этапы
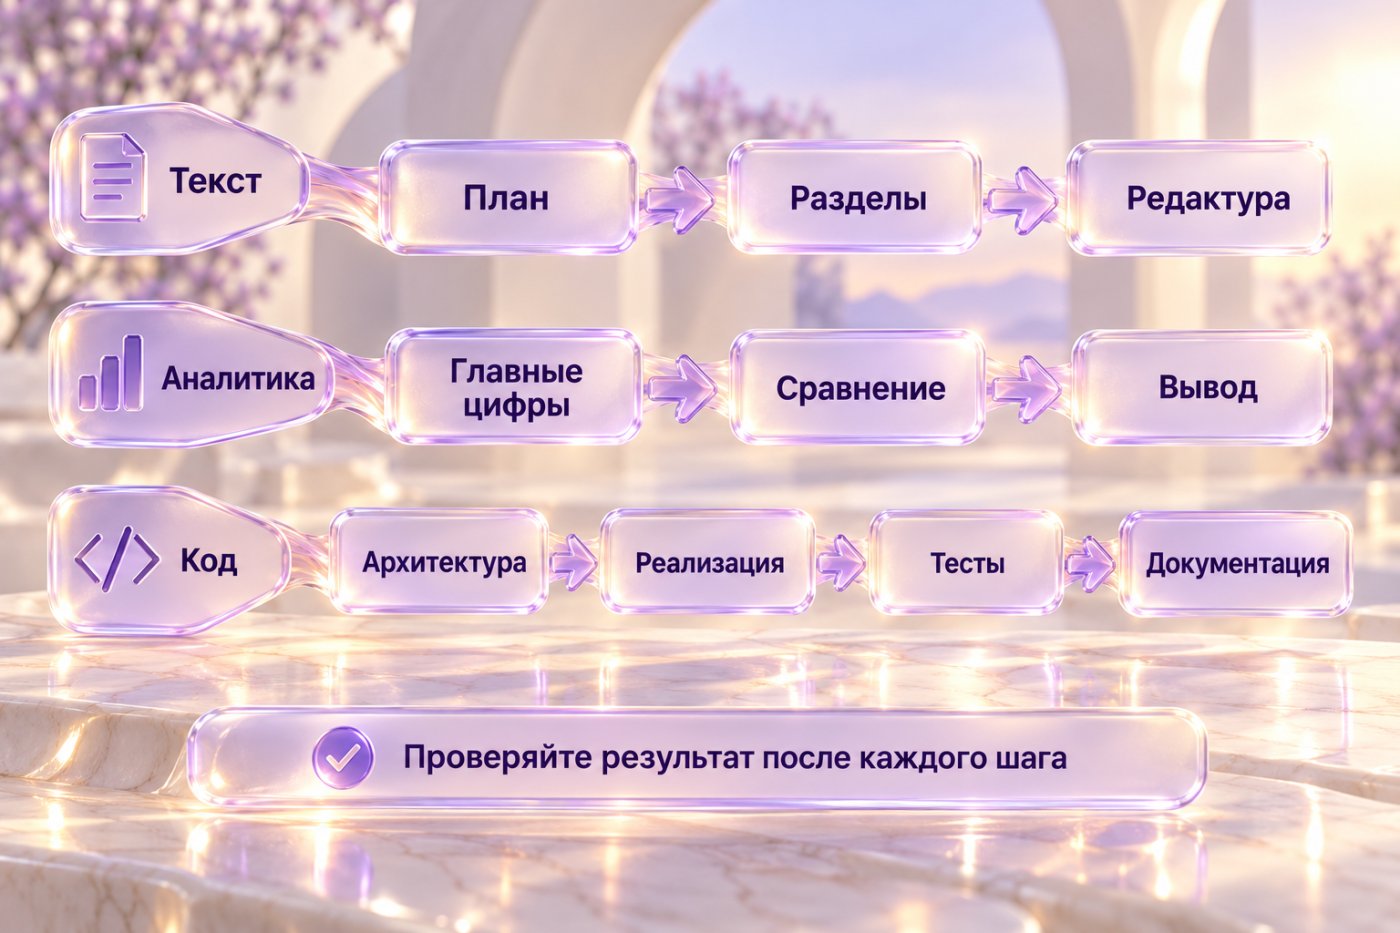
Вместо одного перегруженного запроса разбейте работу на несколько коротких.
Первый запрос: «Составь план статьи на тему "Как выбрать CRM". Пять разделов с краткими подпунктами».
Второй: «Напиши вводный раздел по этому плану: [вставьте план]».
Третий: «Теперь раздел "Критерии выбора", 300 слов, тон деловой». Такая цепочка дает больше контроля над текстом.
Цепочки работают и в аналитических задачах.
Сначала: «Прочитай этот отчет и выпиши главные цифры».
Затем: «Сравни эти цифры с прошлым кварталом: [вставьте данные]. Укажи, где рост, где падение».
Наконец: «Напиши краткий вывод на основании сравнения, два абзаца, для презентации руководству».
Каждый шаг проверяется отдельно, ошибки не накапливаются.
При работе с кодом цепочка выглядит так: первый промпт — архитектурное решение (какие классы, модули, зависимости), второй — реализация ключевого модуля, третий — тесты, четвертый — документация. Получается аккуратный проект, где каждый элемент отвечает своей функции, а не месиво из одного ответа модели.
Ограничения и проверка: как просить модель не выдумывать
Чтобы Qwen не выдумывала факты, добавьте в промпт: «Если ты не знаешь точного ответа, так и скажи. Не придумывай цифры, даты, названия и ссылки. Если сомневаешься, укажи, где именно неуверенность». Это не гарантирует стопроцентной точности, но снижает долю галлюцинаций.
Для фактологических текстов (обзоров, аналитики, технической документации) просите модель ссылаться на источники: «Укажи, откуда взята каждая цифра. Если данные из общедоступного датасета или отчета, назови его. Если это твоя оценка, напиши "оценочно"». Так проще проверить результат перед публикацией.
Если задача требует проверяемого решения (расчет, логический вывод, алгоритм), попросите: «После того, как дашь ответ, перепроверь его. Пройдись по шагам еще раз и укажи, нашлась ли ошибка. Если нашлась — исправь и объясни, где была неточность». Qwen умеет критически оценивать собственные ответы, если об этом явно попросить.
Работа с собственной библиотекой шаблонов
Когда одни и те же типы запросов повторяются, выгоднее использовать собственные готовые промпты и хранить их в текстовом файле или заметках.
Шаблон для поста в соцсетях может выглядеть так:
«Напиши пост на тему [тема]. Целевая аудитория: [аудитория]. Тон: [тон]. Длина: [длина]. Структура: хук, основная мысль, призыв к действию».
Подставляете переменные — и сразу получаете нужный результат.
Для технической документации шаблон:
«Напиши описание функции [название]. Входные параметры: [список]. Возвращаемое значение: [тип]. Добавь пример использования, обработку ошибок и комментарий об ограничениях».
Такие заготовки экономят время и делают документацию однородной по стилю.
Библиотеку шаблонов стоит версионировать: если заметили, что модель стала иначе реагировать на старую формулировку, скорректируйте промпт и сохраните обновленную версию. Qwen развивается, и запросы, работавшие полгода назад, могут потребовать уточнений. Фиксируйте изменения, чтобы не терять наработки.
Частые ошибки и как их избежать
Модель повторяется или уходит в общие фразы
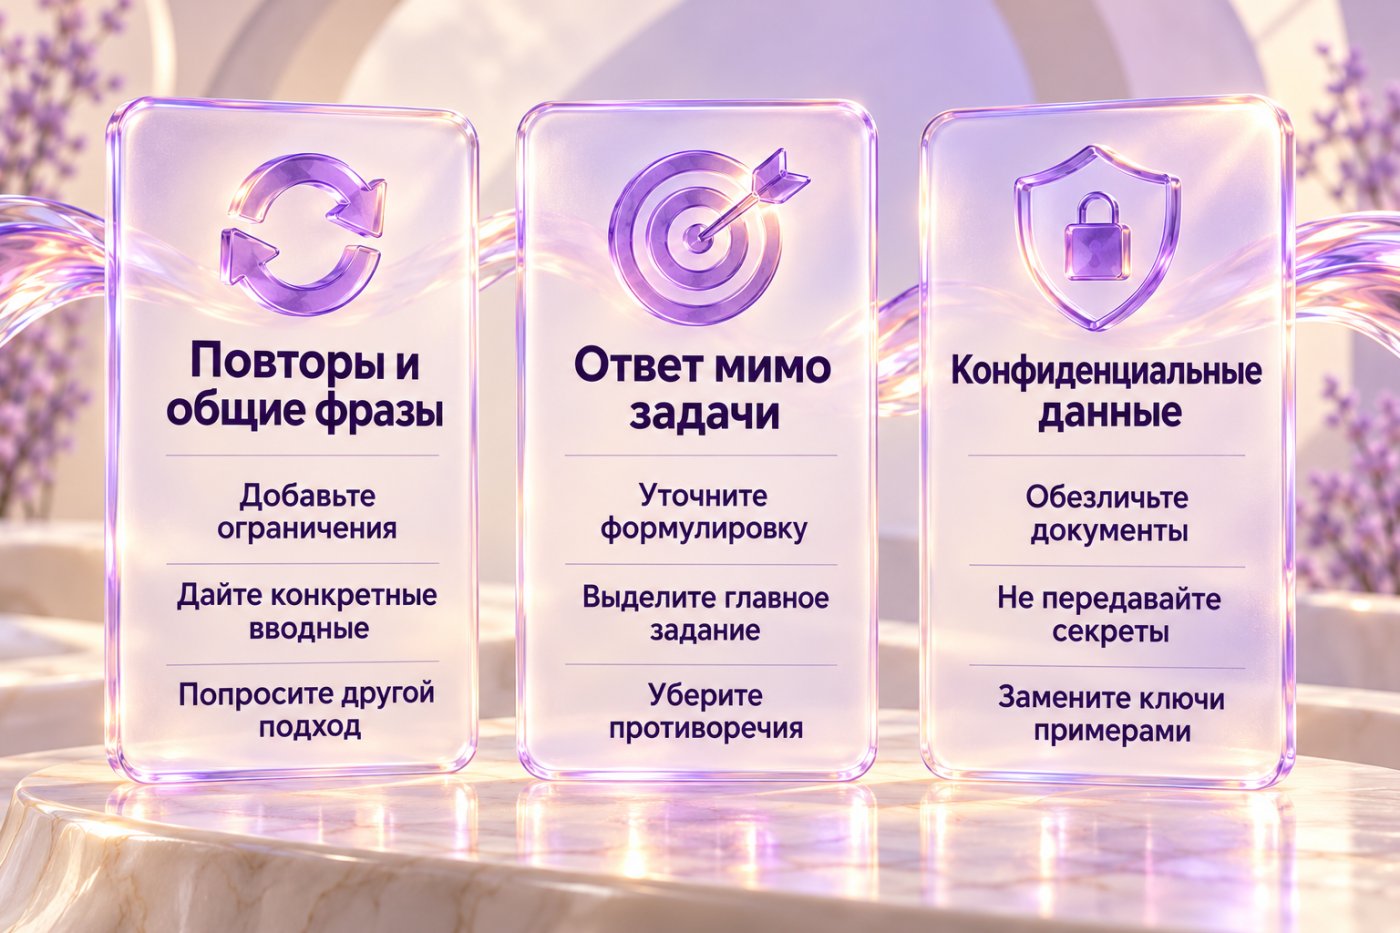
Повторы возникают, когда промт не задает достаточно ограничений. Если Qwen пишет «таким образом», «в заключение», «как было сказано выше» в каждом абзаце, добавьте в запрос: «Не используй вводные конструкции и слова-связки. Каждый абзац начинай с новой мысли, без отсылок к предыдущему тексту».
Общие фразы появляются, когда модели не хватает контекста. Вместо конкретных рекомендаций она выдает «это зависит от ситуации» или «важно учитывать множество факторов». Исправление: добавьте в запрос конкретные вводные данные и попросите привести примеры. Чем больше деталей, тем меньше абстракций в ответе.
Если Qwen застряла в цикле и повторяет одно и то же, прервите диалог и начните новый запрос с формулировки «Предложи альтернативный подход к этой задаче. Не повторяй то, что уже было сказано. Покажи другой способ решения». Смена угла зрения часто разрывает цикл.
Ответ не соответствует запросу: где искать причину
Первая причина — двусмысленность формулировки. Если модель поняла задачу не так, перечитайте промпт: возможно, глагол допускает несколько толкований или контекст описан нечетко. Переформулируйте явно: вместо «опиши процесс» — «перечисли пять шагов процесса с кратким пояснением каждого».
Вторая причина — избыток деталей, среди которых потерялась главная задача. Qwen обрабатывает весь текст запроса, и если в нем три абзаца вводных и одно предложение с реальным заданием, модель может зацепиться за вводные. Решение: сначала контекст и вводные, в конце — явная задача одним предложением, начинающимся с глагола.
Третья причина — конфликт между явными и неявными требованиями. Например, промпт требует «краткий ответ», но задает десять вопросов, к каждому из которых нужно развернутое пояснение. Проверьте, нет ли противоречия между объемом задачи и ограничениями. Если есть — либо сократите задачу, либо уберите лимит.
Конфиденциальность: что не стоит передавать в промт
Не отправляйте в Qwen персональные данные: имена, телефоны, email, адреса реальных людей без их согласия. Если нужно обработать документ с такими данными, замените их на плейсхолдеры: вместо «Иван Иванов, +7 (999) 123-45-67» напишите «[Имя], [Телефон]». После получения ответа подставите реальные данные обратно.
Коммерческие тайны, внутренние отчеты, неопубликованные цифры, стратегические планы — все это не должно попадать в запросы к облачным моделям. Если задача требует работы с конфиденциальной информацией, используйте локальный запуск Qwen или корпоративную версию с гарантиями приватности.
Пароли, API-ключи, токены, учетные данные — даже в виде примеров — не включайте в промпты. Qwen может случайно использовать их в ответе, если попросить сгенерировать код или конфигурацию. Вместо реальных ключей пишите "API_KEY": "your_key_here" или "token": "example_token".
FAQ: про промты для Квен
Можно ли использовать промты для Qwen на русском языке, или английский даст более точный результат?
Qwen корректно обрабатывает русский язык и смешанные запросы, где часть терминов на английском. Для текстовых задач разница между русским и английским промптом минимальна: модель понимает оба языка и выдает ответы сопоставимого качества. Исключение — узкоспециализированные технические темы, где англоязычных данных в обучающей выборке больше: там запрос на английском может дать чуть более детальный ответ.
Для работы с кодом язык промптинга почти не важен: пишете «напиши функцию на Python» или «write a Python function» — результат будет одинаковым, потому что синтаксис кода универсален. Гораздо важнее точность формулировки: укажите входные параметры, ожидаемый формат вывода, версию библиотеки. Если привычнее думать на русском, используйте русский: это экономит время и снижает риск двусмысленности в формулировках.
Как получить от Qwen Max более точный результат по сравнению с базовой версией модели?
Qwen Max — самая крупная версия в линейке, с большим объемом параметров и расширенным контекстным окном. Для сложных задач (анализ многостраничных документов, генерация длинного связного текста, отладка запутанного кода) Max показывает лучшую связность и реже теряет нить рассуждений. Чтобы выжать максимум, подавайте больше контекста в промпт: если базовая версия справится с двумя абзацами, Max потянет десять страниц исходника и выдаст структурированный анализ.
Для коротких задач (написать пост на 100 слов, перевести абзац, сгенерировать заголовок) разницы между Max и базовой версией почти нет: обе справятся одинаково быстро и точно. Использовать Max выгодно, когда задача требует удержания длинного контекста, многоступенчатых рассуждений или работы с несколькими документами одновременно. В остальных случаях базовая версия экономит ресурсы и время ответа.
Что делать, если в ответе Qwen выдумывает факты или ссылки?
Галлюцинации — известная проблема всех языковых моделей: Qwen может сгенерировать правдоподобно звучащую, но несуществующую ссылку, цитату или статистику. Чтобы снизить риски, добавьте в промпт: «Если не знаешь точного ответа, так и скажи. Не придумывай цифры, названия и источники». Это не устраняет галлюцинации полностью, но модель начинает чаще признавать незнание вместо генерации выдумки.
После получения ответа проверяйте фактические утверждения: цифры, даты, имена, ссылки на исследования. Если Qwen ссылается на источник, попробуйте найти его через поиск: часто такие ссылки не существуют. Для критически важных текстов (статей, отчетов, технической документации) выделяйте время на фактчекинг: модель помогает ускорить формирование черновика, но не заменяет финальную проверку.
Если галлюцинации повторяются в одной и той же теме, смените подход: вместо «расскажи о X» попросите «объясни, что известно о X, и укажи, где данных недостаточно». Или используйте цепочку промтов: сначала «составь список утверждений по теме X», затем «для каждого утверждения укажи, можно ли его проверить и как». Такая структура заставляет модель явно разделять факты и предположения.
Начните с простых задач: попросите Qwen переписать абзац, составить список идей или объяснить фрагмент кода. Первые несколько запросов покажут, как модель реагирует на ваши формулировки — и станет понятно, где добавить контекст, где ужесточить ограничения, где показать пример. Сохраняйте удачные варианты: готовый промт для Qwen, который сработал однажды, с высокой вероятностью сработает снова — достаточно подставить новые данные. Экспериментируйте с цепочками, уточнениями, форматами. Чем больше практики, тем быстрее находится формулировка, которая дает нужный результат с первой попытки.
Если у вас есть рабочие промты для нейросети Qwen, которые стабильно выдают сильный ответ, или, наоборот, примеры неудачных запросов — делитесь в комментариях: разбор чужого опыта часто открывает новые подходы.